DB障害はなぜ気づいた時には手遅れなのか?予兆検知と原因調査の仕組みづくり
データベース障害の多くは、実は前触れなく発生しているわけではありません。
「応答時間が数百ミリ秒だけ遅くなる」
「特定のバッチ処理だけ完了までの時間が伸びる」
こうした小さな変化が、大規模な障害の数日前から静かに現れているケースは少なくありません。それでも「気づいた時にはもう遅い」という状況が繰り返されるのはなぜなのでしょうか。本記事では、障害の予兆をどう捉えるかという検知の考え方から、検知後に立ちはだかる原因調査の属人化という壁、そしてそれらを一気通貫で解消する仕組みづくりまでを解説します。
目次[非表示]
「気づいた時にはもう遅い」障害対応が繰り返される理由
障害対応が後手に回る背景には、障害が突発的な出来事ではなく予兆を伴って進行するという性質と、その予兆を捉えきれない監視体制という二つの要因が重なっています。
ここでは、障害がどのように始まり、なぜ既存の監視ではそれを見逃してしまうのかを順に見ていきます。
障害はある日突然起きるのではなく、予兆から始まっている
データベース障害の多くは、パフォーマンスの緩やかな劣化から始まります。ロック待ちの増加、特定インデックスの断片化などは、システム停止という結果に至るまでの過程で段階的に進行するのが一般的です。
しかし、こうした変化は一つひとつが小さく、日々の運用の中では「いつもと少し違う」程度にしか映りません。担当者が体感として違和感を持ったとしても明確な根拠がなければアラートには結びつかず、異常が積み重なった末に、ある日突然サービス停止という形で表面化します。
予兆の段階で捉えられなかった変化は、後の原因調査の材料としても残りにくいという二次的な問題も生みます。
固定閾値の監視だけでは異常を見逃す・誤検知が増える
多くの現場で採用されている監視は「CPU使用率が80%を超えたら通知する」といった固定閾値型です。仕組みがシンプルで運用しやすい一方、時間帯や曜日によって変動する正常な負荷パターンを考慮できないという弱点を抱えています。
状況 | 固定閾値型監視での傾向 |
月末バッチなど想定内の高負荷 | 誤検知(アラート過多)が発生しやすい |
深夜・早朝の緩やかな異常上昇 | 閾値に届かず見逃されやすい |
業務内容の変化 | そのたびに閾値の再設定が必要になる |
値を厳しくすれば誤検知が増えて現場のアラート疲れを招き、緩くすれば本当に重要な予兆を見逃します。「固定の数値で線を引く」という発想そのものに、検知精度の限界があるといえるでしょう。
障害の予兆をどう捉えるか
固定閾値の限界を踏まえると、次に必要になるのは「何をもって異常とするか」という基準そのものの見直しです。ここで有効になるのがシステムごとの正常な挙動を学習し、そこからの逸脱をもって異常と判定する考え方です。
正常時の挙動を学習し、そこからの逸脱で異常を捉える考え方
この方式では、時間帯や曜日ごとの通常の応答時間、CPU使用率、SQL実行件数といった指標を継続的に収集し、システムごとの普段のリズムをベースラインとして構築します。そのうえで、実際の値がベースラインから統計的に有意な範囲を超えて逸脱した場合にアラートを発します。
固定閾値と異なり、月末の高負荷やキャンペーン時のアクセス集中といった想定内の変動は正常範囲として扱われるため、誤検知を抑えつつ、これまで気づけなかった緩やかな劣化も捉えやすくなります。閾値を人が都度調整する必要がなく、システムの成長や利用パターンの変化にも自然に追従できる点も、実務上の大きな利点です。
検知できても「原因が分からない」という問題
予兆を的確に検知できるようになっても、それだけで障害対応が楽になるわけではありません。アラートが発報されたあと、実際に何が原因なのかを突き止める調査フェーズには、検知とは別の課題が存在します。
ここでは、原因調査が長引く典型的なケースと、その背景にある属人化の実態、そして近年新たに浮上しているAI生成SQLという要因を見ていきます。
アラートは出たが、何が原因か分からず調査が長引くケース
「応答時間が悪化している」という現象は検知できても、原因がロック競合なのか、実行計画の変化なのか、あるいはアプリケーション側の呼び出し方の変化なのかは、アラート単体からは判断できません。担当者は複数のログやツールを横断的に確認し、仮説を立てては検証するという作業を繰り返すことになります。
この調査には、データベース・インフラ・アプリケーションそれぞれの知識が必要になる場面が多く、一人の担当者だけでは完結しないケースも珍しくありません。結果として検知から原因特定までに数時間を要し、その間サービスへの影響が続くという事態が起こります。
原因調査が特定の担当者に依存する属人化・ブラックボックス化の実態
多くの現場では、「このシステムの癖を知っているのはあの人だけ」という状況が存在します。過去の障害経験や設計に関する背景知識が特定の担当者にしか共有されておらず、マニュアル化されていないためです。
この属人化は、担当者の異動や退職によって一気に表面化するリスクをはらんでいます。加えて調査の過程がブラックボックス化していると、なぜその結論に至ったのかを他のメンバーが検証できず、ノウハウが組織に蓄積されないという悪循環も生まれます。
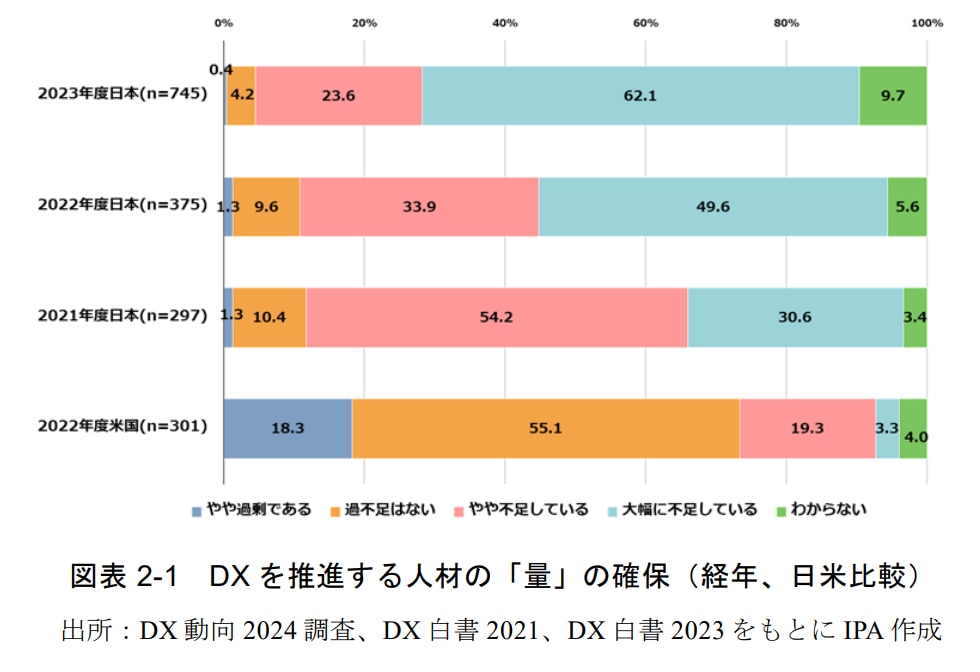
IT人材の不足と技術の属人化は、データベース運用に限らない共通課題として公的な調査でも裏付けられています。独立行政法人 情報処理推進機構(IPA)の『DX動向 2024 - 深刻化するDXを推進する人材不足と課題』によれば、DXを推進する人材が「大幅に不足している」と回答した日本企業の割合は2023年度に62.1%となり、調査開始以来初めて過半数を超えました。
画像引用元:独立行政法人 情報処理推進機構『DX動向 2024 - 深刻化するDXを推進する人材不足と課題』
同時期の米国企業では「過不足はない」との回答が5割を超えており、日米で状況が大きく異なります。同調査ではさらに、「システム開発の内製化」において人材の確保・育成が難しいと回答した企業が9割近く(87.4%)にのぼるとされ、システムを支える人材そのものの不足が浮き彫りになっています。限られた人材に業務が集中する状況では、知識やノウハウが特定の担当者に偏り、属人化が進みやすくなります。
またIPAが公開する障害対策の手引きでは、個人の力量に頼った属人的な仕事のやり方が続くと、品質の不安定化・納期の不確実化・コストの増大を招くと指摘されています。データベースの原因調査においても、同様の構造的リスクが当てはまるといえるでしょう。
出典:独立行政法人 情報処理推進機構『DX動向 2024 - 深刻化するDXを推進する人材不足と課題』
AIによる動的に生成されるSQLの増加と解析難易度の上昇
近年は、生成AIを活用したコーディング支援ツールやローコード開発基盤によって、開発者自身が手を動かして書いていないSQLがアプリケーションから発行されるケースが増えています。ORMや自動生成ツールが背後で組み立てるSQLは、コードレビューの段階では構造や意図が見えにくく、性能特性を事前に把握しづらいという特徴があります。
こうしたSQLが本番環境で問題を起こした場合、コード側の調査だけでは原因にたどり着けず、データベース側で実際に何が実行されたかを直接確認する必要性が高まります。SQLの発行元がブラックボックス化しやすい時代だからこそ、データベース側での可視化の重要性は増しているといえます。
原因調査を属人化させないために必要な情報とは
属人化した調査を仕組みとして再現可能にするには、担当者の経験や勘に頼らずとも判断できるだけの情報が、平時から蓄積されている必要があります。
ここでは、押さえるべき情報の切り口と、それを日常的に記録しておくことの意味を整理します。
「何が実行されたか」だけでなく「どこから実行されたか」
原因調査の精度を左右するのは、実行されたSQL文そのものだけではありません。どのアプリケーション、どの画面、どのバッチ処理、どのユーザーセッションから発行されたのかという実行元の情報が揃って初めて、問題の切り分けが可能になります。
SQL文だけを見て「重いクエリだ」と判断できても、それがどの業務機能に紐づくのかが分からなければ、対応の優先順位も影響範囲の見積もりも困難です。実行元の文脈情報は、経験の浅い担当者でも状況を正しく把握するための手がかりになります。
実行SQL・セッション情報を平時から記録しておくことの価値
原因調査で最も避けたいのは、「障害発生時に必要な情報がそもそも記録されていなかった」という事態です。トレースを事後的に有効化しても、問題が起きた瞬間のデータはすでに失われています。
平時からSQLの実行内容とセッション情報を継続的に記録しておけば、障害発生時にはその履歴を遡って比較するだけで、通常時との差分を素早く特定できます。この蓄積は、単なる障害対応の効率化にとどまらず、将来的な性能改善やキャパシティプランニングの判断材料としても活用できます。
予兆検知から原因調査まで一気通貫で行う仕組みづくり
ここまで見てきた予兆検知と原因調査という二つの課題は、別々の仕組みで個別に対応するのではなく、一つの基盤で連続的に扱えることが理想です。最後に、実際に仕組みを検討する際にチェックすべき観点と、その具体例を紹介します。
チェックすべき観点
仕組みを選定・構築する際には、以下の観点を満たしているかを確認することをおすすめします。
チェック項目 | 確認のポイント |
ベースライン学習 | 固定閾値ではなく、時間帯・曜日別の正常挙動を学習しているか |
SQL・セッションの常時記録 | 事後有効化ではなく、平時から実行情報を蓄積しているか |
実行元の可視化 | SQL文だけでなくアプリケーション・ユーザー単位まで追跡できるか |
履歴比較のしやすさ | 過去のベースラインと現在の状態を容易に比較できるか |
これらが揃って初めて、予兆の検知から原因調査までを同じデータ・同じ画面上で完結させられます。逆にいずれか一つでも欠けていると検知はできても調査は結局担当者頼みになってしまいます。
MaxGauge・exemONEによるベースライン監視
日本エクセムが提供するMaxGaugeは、データベースの正常時の挙動を学習し、そこからの逸脱を捉えるベースライン型の監視を行いながら、SQLの実行内容やセッション情報を平時から継続的に記録する仕組みを備えています。
さらに、インフラからデータベースまでを横断的に可視化するexemONEと組み合わせることで、予兆の検知から原因調査までを一つの基盤上で一気通貫に行うことが可能になります。属人化した調査プロセスを、再現可能な仕組みへと変えたいと考える場合、こうしたベースライン監視の考え方は有力な選択肢の一つです。
まとめ
データベース障害の多くは突発的な事象ではなく、予兆を伴って進行します。固定閾値の監視ではその予兆を捉えきれず、正常時の挙動を学習してそこからの逸脱を検知するベースライン型のアプローチが有効です。
また、検知だけで障害対応が完結するわけではありません。原因調査が特定の担当者に依存する属人化を防ぐには、「何が」だけでなく「どこから」実行されたかという情報を、平時から記録しておくことが欠かせません。生成AIによるSQLの自動生成が広がる今、データベース側での可視化の重要性はさらに高まっています。
予兆検知と原因調査を一気通貫で行える仕組みづくりに関心をお持ちの方は、MaxGauge・exemONEの詳細資料をご覧いただくか、お気軽にお問い合わせください。