DB運用の自動化はどこまで可能か?人手不足・属人化を解決する現実的な進め方
「もう人手だけでは回らない」
多くのデータベース運用現場が抱いている実感ではないでしょうか。夜間のアラート対応、退職予定の管理者しか把握していない設定情報、増え続ける監視対象。こうした課題を前に、「運用自動化」という言葉に期待を寄せる企業が急増しています。
しかし自動化と一口にいっても監視・異常検知・原因調査・復旧対応など対象範囲は幅広く、どこまで機械に任せられるかは領域によって大きく異なります。「自動化すればすべて解決する」という単純な話ではなく、技術的にできることと、現場が安心して任せられることの間には、まだ距離があるのが実情です。
本記事では、DB運用における自動化の現実的な到達点を段階別に整理し、完全自動復旧が難しい理由や人の判断が必要な領域との切り分け方まで解説します。
目次[非表示]
なぜ運用自動化が急務なのか
DB運用の現場では、人材・体制・スピードという3つの側面で限界が同時に訪れています。IT人材不足による属人化の進行、24時間365日監視を支える体制の疲弊、そして障害対応の遅れが招く事業損失。いずれも一朝一夕には解決できない構造的な課題であり、だからこそ人手を前提としない運用の仕組みづくりが急がれています。
採用や教育で人材を増やすアプローチには限界があり、今いる人員でどこまで対応できるかという発想の転換が求められています。それぞれの実態を公的な調査データとともに見ていきます。
IT人材不足とDB管理者の高齢化・退職による属人化リスク
結論、DB運用の担い手は減り続けており、属人化はすでに構造的な問題です。経済産業省の試算では、IT人材は2030年に最大79万人不足すると見込まれています。加えてIPAの調査でも、DX人材が大幅に不足していると回答した企業は6割を超え、2021年度から倍増しました。専門知識が特定の管理者に集中したまま退職・異動が進めば、設定やチューニングのノウハウごと失われかねません。
障害対応の手順や過去の変更履歴が個人の記憶やメモに依存している状態は、担当者が不在になった瞬間に組織としての対応力を大きく損なうリスクをはらんでいます。
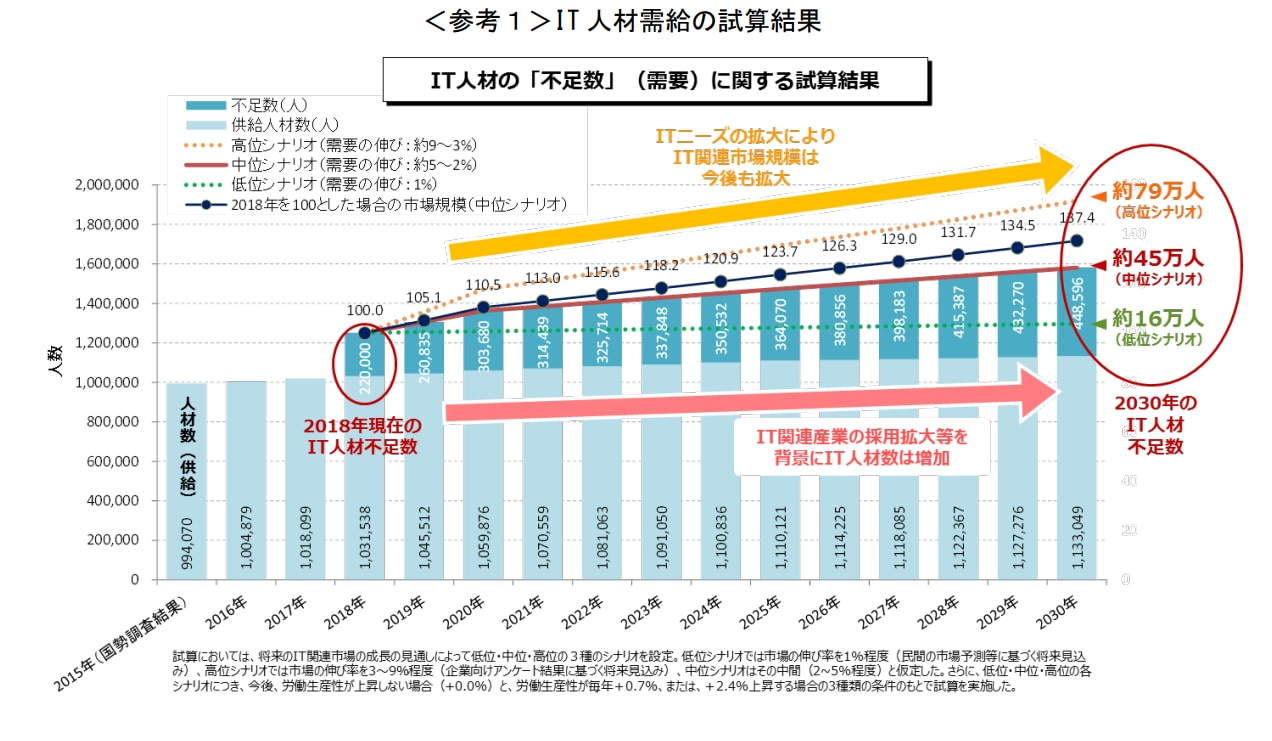
画像引用元:経済産業省『IT人材需給に関する調査(概要)』
出典:経済産業省『IT人材需給に関する調査(概要)』/独立行政法人 情報処理推進機構『DX動向 2024 - 深刻化するDXを推進する人材不足と課題』
24/365監視を人力で維持することの限界とオンコール疲弊の実態
結論、当番制の監視体制は担当者の疲弊と対応品質の低下を招きます。深夜や早朝を問わないアラート対応が常態化すると通知の確認から状況把握、一次対応の完了までに要する時間はどうしても長くなりがちです。
判断力が低下した状態での対応は見落としや誤操作のリスクを高め、体制そのものが持続不可能になっていきます。特にDB運用は専門性が高いため対応できる人数が限られやすく、結果として特定の担当者に負荷が集中しやすいという構造的な問題も見逃せません。
障害対応の初動遅れが事業損失に直結する
結論、初動の遅れは損失額に直結します。原因調査に時間を要するほど業務停止やサービス影響の継続時間は延び、機会損失や顧客からの信頼低下といった被害は連鎖的に拡大します。
障害そのものを完全にゼロにすることは現実的ではありません。だからこそ、発生を前提としたうえで「どれだけ早く原因を特定し、影響範囲を見極められるか」が、最終的な損失の大きさを左右する分岐点になります。
DB運用のどこまでが自動化できるのか
自動化は一つの機能ではなく、監視・異常検知・原因調査という段階の積み重ねです。段階ごとに求められる技術や成熟度は異なり、すべてを一度に自動化しようとすると失敗しやすくなります。それぞれの段階でどこまで実現可能か、現実的な到達点を整理します。
段階 | 主な内容 |
監視 | 閾値によるリソース監視 |
異常検知 | ベースライン学習による兆候把握 |
原因調査 | SQL・セッション情報の収集と可視化 |
監視の自動化:閾値・ベースラインによる異常の検知
結論、閾値監視はすでに広く自動化されている領域です。CPU使用率やディスク使用量、接続数といった指標に静的な閾値を設定し、超過時にアラートを発する仕組みは多くの現場で稼働しています。
導入コストが比較的低く、効果を実感しやすい入り口ともいえます。ただし固定閾値だけでは、時間帯や業務サイクルによる正常な変動まで異常と誤検知しやすいという弱点があります。閾値の見直しを怠ると、アラートが鳴り続ける「アラート疲れ」を招く点にも注意が必要です。
異常検知の自動化:正常時の挙動学習と兆候の早期把握
結論、正常時の挙動を学習させることで、閾値到達前の兆候を捉えられるようになります。過去のリソース使用パターンやSQL実行傾向をベースラインとして蓄積し、そこからの乖離をスコア化する仕組みが代表的です。
これにより「まだ閾値には達していないが、いつもと違う」という予兆段階での気付きが可能になります。曜日や時間帯による周期的な変動を織り込めるため、固定閾値よりも誤検知を抑えられる点も実務上のメリットです。
原因調査の自動化:SQL・セッション情報の自動収集と可視化
結論、原因調査は自動収集と可視化によって大幅に短縮できます。遅延の原因となったSQLやセッション、待機イベントの情報を常時記録しておけば、障害発生時に手作業でログを掘り起こす必要がなくなります。
システム全体の状態からセッション、SQLへと掘り下げる分析フローを備えたツールを使えば、原因特定までの時間を大きく圧縮できます。属人化した経験に頼らず、誰が対応しても同じ手順で根本原因にたどり着ける状態をつくれる点は、人材不足への対策としても有効です。
完全自動復旧は現実的か?よくある誤解と実態
監視から原因調査までは自動化が着実に進む一方、異常を検知した後の「復旧」まで機械に任せきる、いわゆる完全自動復旧は依然としてハードルが高い領域です。技術的な制約に加え、現場の心理的な抵抗感も無視できません。
「自動化=すべて自動」という期待を持ったまま導入すると、期待と実態のギャップに失望しかねないため、この点は誠実に説明しておく必要があります。
自動チューニング・自動インデックス作成が抱えるリスク(本番DBへの影響)
結論、自動チューニングは本番環境に予期しない影響を及ぼすリスクを伴います。実行計画の自動変更やインデックスの自動作成は、テスト環境では有効でも、本番特有のデータ量やアクセスパターンのもとでロック競合や性能劣化を引き起こす場合があります。
取り返しのつく変更かどうかを見極めないまま自動実行することは、事業継続の観点からも慎重であるべきです。特にピークタイムやバッチ処理と重なるタイミングでの自動実行は、想定外の影響範囲に広がるリスクが高くなります。
なぜ最終判断は人が担うべきなのか
結論、業務影響を踏まえた最終判断には、機械が持ち得ないビジネス文脈の理解が欠かせません。
同じ異常でも、決算処理中か通常時かによって許容できる対応は変わります。加えて実務の現場では、「自動復旧の判断を全面的に信用しきれない」という心理的なハードルも根強く存在します。
これは技術的な成熟度以前に、誤った復旧アクションが事業に与える影響の大きさや、責任の所在・説明責任に関わる問題であり、現時点では正直に向き合うべき論点です。
自動化すべき領域と人の判断が必要な領域の切り分け方
結論、情報収集・分析までを自動化し、実行判断は人が担うという線引きが現実的です。取り返しがつく作業か、業務影響が及ぶ作業かを基準に考えると判断しやすくなります。
領域 | 自動化の適性 | 理由 |
監視・異常検知 | 高い | 定型的なデータ収集・比較処理 |
原因調査・可視化 | 高い | 情報の集約と関連付けが中心 |
軽微なアラート通知 | 高い | 判断を伴わない定型処理 |
インデックス変更・チューニング実行 | 低い | 本番影響のリスクが大きい |
復旧アクションの実行判断 | 低い | 業務文脈の理解と説明責任が必要 |
この切り分けを組織内で明文化しておくことが、自動化を無理なく進める前提になります。
自動化の本質は判断材料の収集を止めないこと
完全自動復旧が現実的でないからこそ、自動化の価値は復旧そのものよりも「判断材料を止めずに集め続けること」にあります。人が正しく速く判断するための土台づくりこそが、自動化の本質だといえます。
復旧の自動化ばかりに目が向きがちですが、実務上の効果は情報収集の自動化にすでに表れています。ここでは、判断材料が不足するとなぜ初動が遅れるのか、その構造を確認します。
判断が遅れる最大の原因は情報が揃っていないこと
結論、判断の遅れは能力不足ではなく情報不足から生じるケースがほとんどです。
障害発生後にログをかき集め、担当者に聞き取りを行い、状況を再現しようとする間に時間が失われます。ベテラン担当者ほど「経験と勘」で乗り切ってしまうため、情報不足の問題そのものが表面化しにくいという側面もあります。必要な情報がすでに手元にあれば、判断そのものはそれほど時間を要しません。
平時からのデータ収集が有事の初動を左右する
結論、平常時のデータこそが有事の判断基準になります。正常な状態のリソース使用率やSQL実行傾向を記録し続けていなければ、異常が起きた際に「何が普段と違うのか」を比較する物差しがありません。
障害が起きてから監視を強化しても、比較対象となる平時のデータがなければ十分な効果は得られません。平時のデータ収集を止めないことが、有事の初動速度を決めます。
収集すべき情報の粒度
結論、粒度の異なる情報を組み合わせて収集する必要があります。
情報レイヤー | 収集内容 | 用途 |
リソース | CPU・メモリ・I/O使用率 | 全体傾向の把握 |
セッション | 接続数・待機状態 | 影響範囲の特定 |
SQL | 実行時間・実行計画 | ボトルネックの特定 |
待機イベント | ロック・I/O待機の内訳 | 根本原因の特定 |
粒度の粗い情報だけでは初動判断に足りず、粒度の細かい情報だけでは全体像を見失います。両者を揃えておくことが重要です。
運用自動化を実現する具体的な仕組みづくり
自動化は一足飛びに実現するものではなく、段階を踏んで整備していくものです。自社で着手できる範囲と、専門的な基盤に任せるべき範囲を分けて考えることで、無理のない形で仕組み化を進められます。
ここでは、まず自社で始められる取り組みと、外部の専門プラットフォームが担える役割を分けて紹介します。
自社運用でまず着手すべき3ステップ
結論、着手順序を誤らないことが自動化定着の近道です。
現状の監視項目とアラート条件を棚卸しし、重複や漏れを洗い出す
閾値やベースラインを定期的に見直すルールを明文化する
異常検知後のエスカレーションフローと判断権限を整理する
この3ステップは特別なツール導入がなくても着手可能であり、その後の仕組み化の土台になります。逆にこの土台が整わないまま高度なツールだけを導入しても、収集した情報を活かしきれず、効果を実感しにくいままになってしまいます。
exemONEによる監視の強み
結論、exemONEはこうした基盤づくりを支援するプラットフォームです。Oracle、PostgreSQL、SQL Server、MySQL、MongoDBなど多様なデータベースに対応し、オンプレミス・クラウド・PaaSを問わず統一した視点で分析できます。
システム全体の状態からセッション、SQLへと掘り下げる分析フローにより、根本原因の特定を迅速化します。加えて専任エンジニアによる導入設計からチューニングまでの伴走支援や、ProActive型のリモートDBAサービスも提供しており、ツール任せにせず「使いこなす」ところまで支援する体制が整っています。
これまでに29カ国・1,000社以上、25,000を超えるライセンス導入実績があり、日本国内のオンプレミス環境からクラウド・PaaS環境まで幅広く採用されています。
まとめ
DB運用の自動化は、監視・異常検知・原因調査までは実現可能です。一方で完全自動復旧は、技術的なリスクと現場の心理的なハードルの両面から、現時点では現実的とはいえません。この事実を曖昧にせず、できることとできないことを切り分けて伝えることが、自動化を検討する第一歩になります。
重要なのは、自動化できる領域と人が判断すべき領域を切り分けたうえで、平時から判断材料となるデータを収集し続ける仕組みを整えることです。人材不足や属人化は一朝一夕には解消しませんが、判断材料さえ揃っていれば、限られた人数でも精度の高い初動対応は可能になります。
まずは自社の監視項目とエスカレーションフローの棚卸しから着手してみてください。そのうえで、より高度な異常検知や原因調査の自動化を検討する段階になったら、exemONEの導入相談や資料請求からお気軽にお問い合わせください。